



科学实验在自然科学发展中的作用越来越明显, 作为科学实验主要产出之一的科学数据已经成为一种重要资源, 受到越来越多的重视, 高效且结构化的数据提取一直备受关注[1-2]. 化学作为自然科学的三大基础学科之一, 它的研究和应用已经渗透到科学研究、国民经济、社会发展、国家安全各个方面, 形成许多交叉领域, 积累了大量的资料和数据. 对化学资料和数据的需求促进了对化学数据和文献资料的收集与加工整理研究. 化学数据的搜集和加工在国际上已有200多年的历史, 早期的化学数据见于各种化学期刊和手册, 如《Beilstein有机化学手册》(1779~至今)、《Gmelin无机与有机金属化学手册》(1817~至今)、《美国化学文摘》(1907~至今)等, 不过直到2010年化学数据的搜集加工还是以人工处理为主. 2011年剑桥大学Jessop[3]、Hawizy[4]和Lowe[5]等先后发表了用于化合物名称自动识别的化学文本挖掘系统OSCAR4和化学实验(操作)自动识别系统ChemicalTagger, 开创了将基于规则的人工智能方法用于化学数据处理的新方向. 2016年, Swain等[6]发布了一个基于大量化学文章语料库和无监督词聚类建立的工具包ChemDataExtractor, 可以通过标记化、词性标记、命名实体识别和短语解析, 实现从科学文档中自动提取化学实体及其相关属性、测量和关系, 用于生成结构化的化学数据库. 2017年, Kim等[7]使用自然语言处理技术自动编译了数以万计的学术出版物中的材料合成参数, 并用机器学习方法预测通过水热法合成二氧化钛纳米管所需的关键参数, 并根据已知机制验证这一结果, 证明迁移学习的能力优于启发式策略. 2020年, Vaucher 等[8]建立了一种将英语非结构化实验程序转换为结构化合成步骤(动作序列)的方法, 方法通过一组具有预定义属性的合成动作和一个基于Transformer架构的深度学习序列到序列模型, 将实验程序转换为动作序列. 2021年, Schwaller等[9]利用Transformer实现了有机化学相关信息的提取. 2022年, Barzilay等[10]报道了一种基于两个Transformer编码器的化学反应信息提取的深度学习模型, 可实现对反应产物进行提取以及反应中各个角色进行标注, 其中在对于产物提取的F1得分为0.762, 反应角色标注的F1得分为0.787. 2023年, Xiong等[11]报道了一个基于目标检测、图像字幕和合成计算机视觉技术的文献中自动提取化学结构的方法, 可用于生物医学文献的自动化挖掘和数据驱动的分子设计. 2023年, Zheng 等[12]报道了一个基于ChatGPT的化学助手, 用于文献中金属-有机框架(MOF)合成条件的文本挖掘和合成预测. 这些关于期刊文献中各类数据的自动识别提取方法研究主要集中于英文期刊文献, 还没有发现针对中文文献中数据自动识别提取方法的研究, 国内的科学期刊文章主要以中文或英文两种语言发表, 需要能同时支持中英文文献中数据自动识别提取的方法.
目前市场上已经有一些比较成熟的商业化软件用于化学文献的数据挖掘和提取, 例如NextMove公司的LeadMine软件[16], 基于无监督聚类学习方法的Chem-DataExtrctor[17], 以及基于Transformer架构的生成式大模型. NextMove公司的LeadMine软件是一种基于规则的人工智能方法, 也是迄今为止对结构化文本数据识别提取效果最好的一种文本数据挖掘软件, 已经用于美国专利中化学合成方法的自动识别提取, 经过后继的清洗和校验, 建立了可以满足实际应用需要的化学反应数据集(Pistachio). 此软件目前主要支持英文文本的数据挖掘, 按照公司网站的说法, 其化合物名称翻译系统现在也可以支持日语、韩语和汉语, 由于化合物名称中汉字的准确解释可能取决于上下文, 难度远大于基本使用音译的日语和韩语. ChemDataExtractor是一种基于神经网络的人工智能方法, 主要通过大量化学文章的无监督词聚类学习方法建立基本语料库. 我们使用《有机化学》期刊的中英文文章对ChemDataExtractor的性能进行了测试, 初步结果显示这一方法不太适合《有机化学》期刊实验部分的化合物性质数据的文本挖掘(测试结果见结果与讨论). 基于Transformer架构的生成式大模型是近年来人工智能方法的最新进展, 考虑到国内的生成式大模型对中文内容的适应能力更强一些, 我们用阿里巴巴的通义千问[18]生成式大模型进行了《有机化学》期刊中英文文章的化合物性质数据识别提取试验, 初步结果显示生成式大模型的幻觉现象比较严重, 方法对结构化文本数据的识别提取效果一般, 其主要优势在于对非结构化文本数据的识别提取(试验结果见结果与讨论).
1 基于语言表达模式的科学数据自动识别
面向中英文科学期刊文章中知识点、化合物各类性质数据和合成方法的识别提取需求, 我们以《有机化学》期刊文章为例, 针对有机化学研究文章中的实验部分和结果讨论部分开发了一种基于语言表达模式和基于规则的自然语言处理(NLP)的有机化学文献数据自动识别提取方法, 通过对科学数据表达方式的归纳总结得出一种科学数据的语言表达模式(包括适用的场景模式), 然后将其转换成对应的正则表达式[13], 最后通过正则表达式识别定位和提取文章中的科学数据, 这一方法原则上适合所有类型科学数据的自动识别, 包括科学数据和实体(广义的科学数据). 逻辑上科学数据的识别应包括三个层面的工作: 科学数据的识别、科学数据相关实体的识别和科学数据与实体的归属关系识别.
根据科学文献中科学数据的通行采集规则, 一般只采集文章作者通过实验研究得到的科学数据, 而不采集作者引用的其他来源的科学数据. 有鉴于有机化学研究文章中的实验部分和结果讨论部分的表述特点: 实体及其性质数据(科学数据)都在同一个文章段落中, 我们只需进行实体及其性质数据的识别定位, 而无需进行性质数据与实体的归属关系识别.
1.1 科学数据语言表达模式
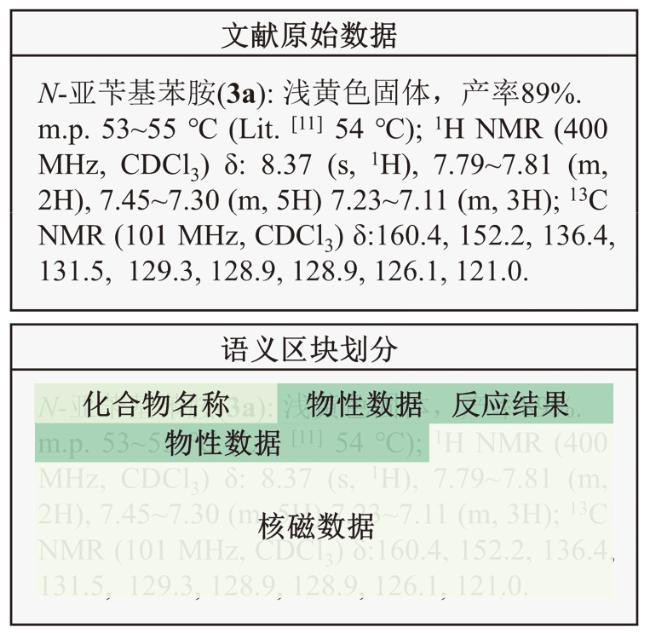
学术文献中的各种科学数据通常都有其相对通用、约定俗成的一种或数种表达方式, 这些通用的表达方式也有助于阅读者对作者所要表述内容和意义的理解, 例如作者在文章的某个段落给出了一个温度值, 除了包含温度的数值和单位(℃或者K), 通常还会在该数据的前部或后部标注这一温度数据的意义, 是指熔点、沸点、分解温度还是爆温, 或者使用特定的位置和格式以说明数据的定义. 对于实验部分的产物性质段落(图1), 可以根据表述格式和数据所处位置确定数据的意义和归属关系, 其中物质名称和产物形态使用格式和相对位置说明数据意义, 文中“浅黄色固体”是指产物(化合物)的性状; 产率、熔点、1H NMR和13C NMR则使用数据前标注说明其意义, 同时借助格式和位置说明这些数据的归属. 此例子说明科学数据的语言表达模式也与其所处的语言环境有关, 例如性状表述模式(浅黄色固体)必须是在实验部分的产物性质段落内才有意义, 因此广义的科学数据表达模式包括科学数据自身的语言表达模式和适用的语言环境模式两部分, 而具有数据前标注的科学数据, 如氢核磁谱数据通常没有适用的语言环境模式限制, 出现在文献的任何部位都表示氢核磁谱.
大部分科学数据由数值部分和物理单位部分两部分组成, 例如温度、密度、速度等, 因此科学数据的语言表达通常具有很多共性部分. 为便于规范和引用, 我们参考XML标签[14]定义了语言表达模式标签, 使用ep (Expression Pattern)作为语言表达模式标签的元素字:<ep语言表达模式名称或编号/ep>. 语言表达模式可以嵌套, 被嵌套者即为前一语言表达模式的子模式, 但是子模式不能与上级语言表达模式相同, 即语言表达模式不允许自嵌套.
科学数据中最常见的是物理性质数据, 这类数据根据其语言表达模式的组成特点分成三大类(图2a). 从图2a中可见, 式中符号使用正则表达式规定, 其中|表示或选, ?表示该部分可以出现0次或1次, 其中的物理单位1和物理单位2代表具体的物理单位. 物理性质数据表达模式通式1的数据意义可以由场景决定, 也可以由作者用文字定义. 本模式中的子模式<ep数值范围/ ep>已知可以有多种形式, 包括但不限于: -108(单个负整数值)、108.5(单个浮点数值)、≥108.5(大于一个浮点数值)、-(108.5±0.9)(一个浮点数值加误差范围)、108.5~120.7(一个浮点数值范围)、108.5和120.7(并列的浮点数值)等. 基于上述情况对应科学数据数值范围<ep数值范围/ep>的正则表达式如图2b所示.
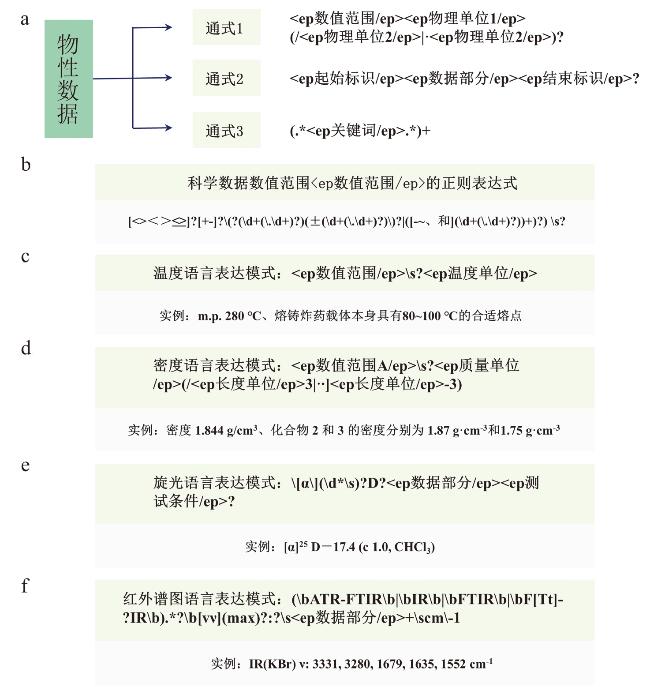
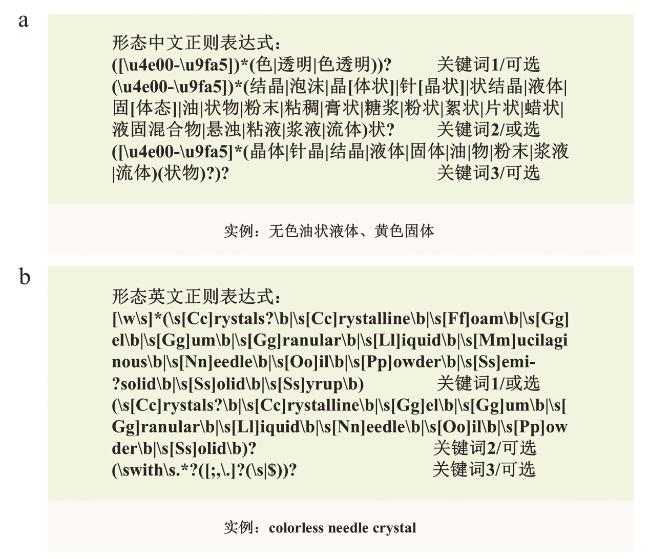
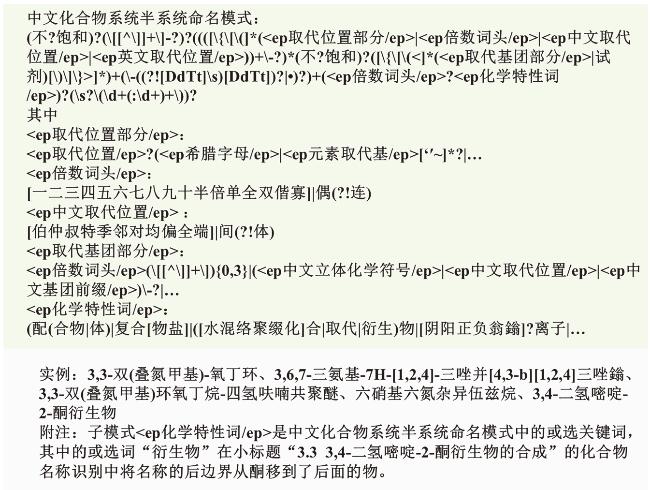
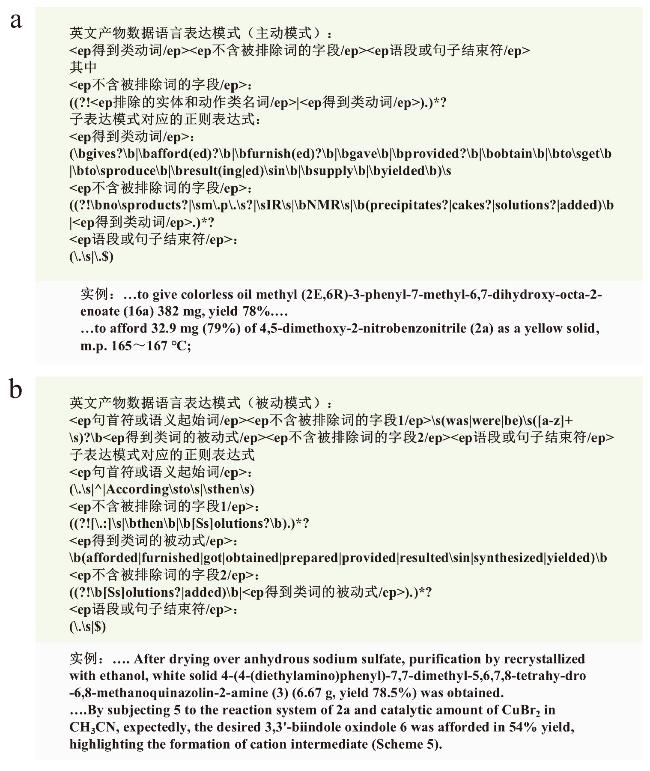
在物理性质数据表达模式通式3中,.表示任意字符, *表示0到n次, +表示1到n次. 此类物理性质数据是文本类数据, 通常需通过多个关键词(组)定义, 数据意义完全由场景确定. 这些关键词根据匹配要求不同可以分成必选关键词、或选关键词和可选关键词三种类型, 其中必选关键词是命中结果中必须包含的关键词, 或选关键词是指多个关键词中必须选择一个, 而可选关键词是指这类关键词在命中结果中可有可无. 必选关键词和或选关键词是一个语言表达模式的核心, 也是一个字串成为命中结果的必要条件, 可选关键词的作用是帮助确定语言表达模式的前后边界(例子见中文化合物系统半系统命名模式的附注). 值得注意的是或选关键词中一些不具备独立意义的词, 以及可选关键词与或选关键词中不具备独立意义词的组合都可能成为干扰自动识别的噪音, 需要后继操作进行排除. 以化合物的形态数据为例(图3).
中文化合物系统和半系统命名也属于物理性质数据表达模式通式3的范例(英文化合物系统和半系统命名的语言表达模式还在研究中), 由于涉及多层子表达模式的嵌套, 此处只给出至第二层子表达模式或对应正则表达式的定义, 过长部分用…号省略.
1.2 使用正则表达式自动识别定位科学数据
由语言表达模式转换而来的正则表达式可以准确识别和定位科学数据, 但是在现实应用中仍然需要满足两个前提, 一是所要处理的文本完全符合语言表达模式定义的整体场景或局部场景, 不存在与所定义语言表达模式类似的干扰, 二是所使用的语言表达模式与最终所需的科学数据格式完全一致, 不包含任何不需要的内容. 为此我们在使用识别定位表达式前增加了一个模式确认环节, 在使用识别定位表达式进行识别定位以后, 增加了一个确认取值环节, 以保证最终结果符合该数据的定义和格式要求. 在《有机化学》期刊文章的模式确认环节中, 使用的各类表达式操作包括模式肯定、模式否定(取消后继识别定位操作)和关键词替换(以避免类似词的干扰); 在确认取值环节中使用的各类表达式操作包括提取科学数据(放弃其余部分)、删除从头部至第一个命中字串的内容、删除从头部至最后一个命中字串的内容、删除从第一个命中字串至尾部的内容、所有非连续命中字串合并成一个结果、从字串中部删除命中字串、进行指定字符串替换、满足条件后肯定操作、满足条件后否定操作、条件操作中的反操作(相当于if语句中的else)、并列数据的分割.
一个科学数据的语言表达模式是否需要前置的模式确认环节和后置的确认取值环节, 取决于语言表达模式的定义是否具有足够的排他性. 前述物理性质表达模式通式2类型的数据表达模式因为有起始标识, 通常不需要模式确认环节, 例如旋光、红外谱图、紫外谱图、各类核磁谱图和各类质谱图, 而物理性质表达模式通式1和通式3类型的数据表达模式都可能需要模式确认环节. 物理性质表达模式通式1类型的数据表达模式借助数值范围后的计量单位进行识别定位, 需要借助模式确认来排除目标科学数据后面的其他计量单位的科学数据, 例如温度数据(℃|K)需要与升温速度数据(温度后面还有时间单位, 如15 ℃•min-1)进行区分; 还有一些科学数据需要借助模式确认来分隔当前科学数据与前面数据计量单位尾部数字的关系, 防止该数字被误认为当前科学数据的并列数值, 例如在字串“生成焓和密度分别为1788.73 kJ•mol-1和1.10 g•cm-3”中, 第一个科学数据生成焓的物质量单位(mol-1)在进行密度数据自动识别时, 尾部的数字1可能会被误认为密度数据并列数值的一部分(1和1.10 g•cm-3), 因此需要用前置模式确认操作, 用于排除干扰的模式确认方法可以有多种, 一个适用于本例的简单方法是将两个物理量之间的并列词“和”或“、”暂时替换成空格. 物理性质表达模式通式3类型的数据表达模式在没有局部场景限制(如产物数据)时, 需要借助模式确认来限制有效字串范围和排除与关键词类似的非关键词. 例如结晶是物质形态数据中的一个物态关键词, 而结晶性就不是物态关键词, 如果一个字串中只有结晶性而没有其他物态关键词, 模式确认环节就会因此否定将该字串作为候选字串的可能性.
一个科学数据的语言表达模式是否需要后置的确认取值环节取决于语言表达模式的定义是否具有足够的排他性, 以及语言表达模式的定义中是否包含作为数据所不需要的内容. 前述物理性质表达模式通式2类型的数据表达模式如果具有特性化的结束标识, 并把起始标识作为结果数据的一部分, 通常不需要后置的确认取值环节, 例如红外谱图、紫外谱图、各类核磁谱图、各类质谱图, 而旋光数据由于其可能包含的测试条件表述方式比较复杂多样, 还可能包含可以作为结束符的逗号容易被混淆, 例如 -17.4 (c 1.0, CHCl3), 因此需要确认取值环节帮助确定旋光数据在字串中的结束位置. 物理性质表达模式通式1类型的数据表达模式只定义了科学数据的物理意义(例如280 ℃), 如果没有特定场景限制或者场景限制不能确定数据意义, 就需要借助确认取值环节来判断该数据的意义是熔点、沸点还是分解温度; 与此类似的产率的物理定义只是一个百分数, 这个百分数是产率还是其他也需要通过确认取值环节来判断数据的意义. 此外, 物理性质表达模式通式3类型的数据表达模式是通过一个或一组关键词定义的, 其中或选关键词中一些不具备独立意义的词, 以及可选关键词与或选关键词中不具备独立意义词的组合, 都可能成为干扰自动识别的噪音, 需要通过确认取值环节进行排除. 例如基团的表达模式由<ep基团定语/ep><ep基团根/ep>两部分组合而成, <ep基团定语/ep>中的或选关键词麦角和<ep基团根/ep>中的或选关键词酸、碱、胺, 可以按需组成以识别麦角酸、麦角碱、麦角胺, 如果一段文字中只有麦角两字, 后面没有酸、碱或胺, 其中的麦角仍会被标记出来成为噪音. 如前所述这类或选关键词中不具备独立意义的词, 可以通过取值环节进行排除, 另一种方法是进一步把<ep基团定语/ep>细分成<ep基团非词尾定语/ep>(如麦角、麦芽、马兜铃等)和<ep基团词尾定语/ep>(如冰片、安息香、甘油等)两个部分, 规定<ep基团非词尾定语/ep>中的或选关键词后面必须跟有<ep基团根/ep>才能存在.
1.3 数据标识系统和数据置标
借助科学数据表达模式对应的正则表达式可以很方便地从文本中识别和定位所想要的科学数据, 这些已经定位的科学数据可以直接提取, 也可以对其添加标识, 等所有处理完成后再一次性提取. 相比较而言, 对已定位科学数据添加标识的方法, 可以支持在线操作直接展示科学数据的识别定位结果, 也可以支持在数据提取对同类型数据的比较选择, 例如当合成反应操作段内容中没有提及产物名称时, 也可以从标题部分提取产物名称(图2). 此外, 某些科学数据的语言表达模式具有指定场景要求, 对已识别定位的场景类科学数据添加数据标识, 可以支持科学数据的分阶段处理, 例如先从合成反应操作段内容中识别定位产物数据内容, 添加数据标识后, 留待下一步从中识别定位合成产物、产率、性状等数据的需要.
根据需要用于期刊文章中科学数据识别提取的数据标识系统可以分成段落标识、内容标识和数据标识三个层次, 使用类似XML的标签[14], 分别用sc (Section Class)作为段落标签的元素字、cc (Content Class)作为内容标签的元素字、dc (Data Class)作为数据标签的元素字. 与语言表达模式ep类似, 数据标识系统也使用编号和名称两种方式表示具体的数据标识, 例如<dc0661>…</dc0661>和<dc红外光谱>…</dc红外光 谱>, 这里dc0661和dc红外光谱均用于标识红外光谱数据, 前者主要用于处理过程以保证标识的规范统一, 后者主要用于结果展示便于使用者理解. 段落标识用于标识一段文本在文章中的文本类型, 分为文章通用段落标识和化学类段落标识两类, 其中文章通用段落标识用于标识某个段落是文章题目、摘要、小标题、正文、图表, 还是参考文献, 对于使用word等文本格式的文章可以直接通过标识转换得到. 化学类段落标识用于进一步对小标题和正文段落按其是否涉及目标化学内容进行分类, 将其细分为实验部分、结果讨论部分、实验部分仪器和试剂、实验部分合成方法、实验部分产物性质等. 内容标识是一种广义的场景标识, 用于标识一段文字的内容类型, 分为仪器试剂、合成操作、产物性质等, 用于解决一个文章段落中可能存在几个不同类型内容的问题, 例如在实验部分合成方法段落可能同时存在合成操作内容和产物性质内容. 数据标识可用于标识局部场景或一组数据(如产物数据), 也可用于标识具体的数据(如熔点、红外谱图等). 对文本内容进行识别定位和添加标识后的结果见图6.
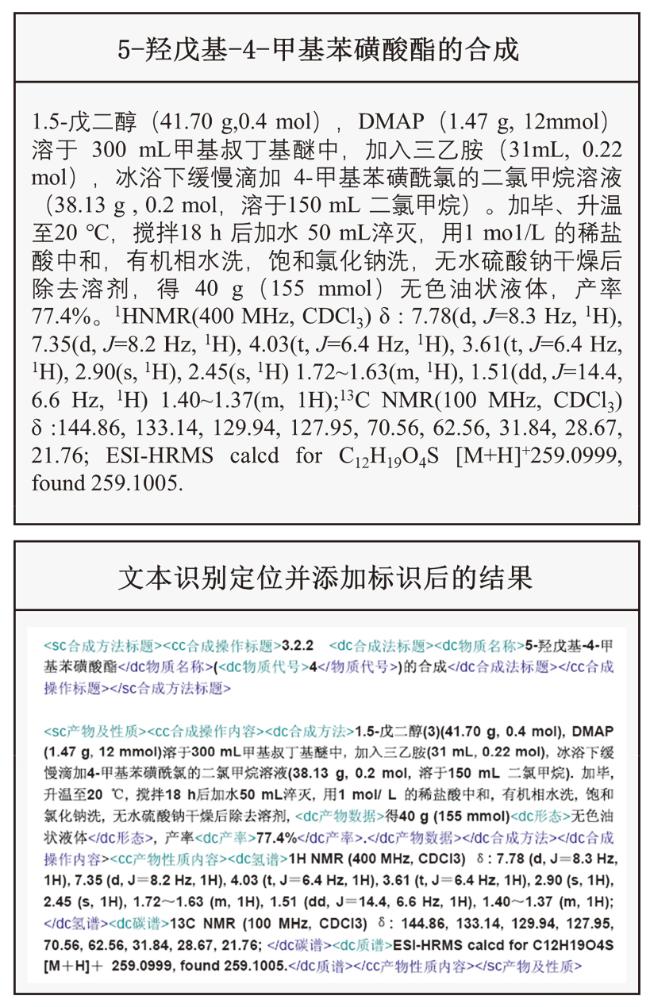
后继数据提取程序可以按照数据标识提取数据, 利用有机化学研究文章中实验部分和结果讨论部分的实体及其性质数据(科学数据)都在同一个文章段落的特点, 认为从此段落中提取的所有性质数据都属于本段落中被标识为物质名称的实体, 当本段落中没有被标识为物质名称的实体时, 数据提取程序可以按照相应规则, 从相邻的小标题段落中提取被标识为物质名称的实体, 将其作为这些性质数据的实体.
2 化学数据自动识别试验
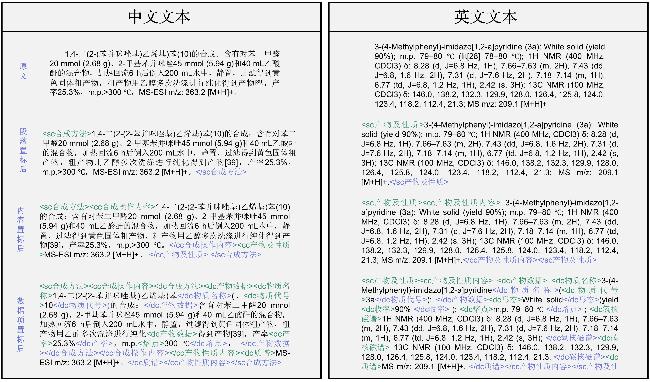
使用上述语言表达模式和基于规则的自然语言处理(NLP)方法, 对《有机化学》期刊2013~2022年发表的全部文章进行了化学数据自动识别试验. 全部文章都为word格式, 先利用office自带的模块将word文件内容转换成附带word段落标识的纯文本, 然后进行化学数据自动识别试验. 整个自动识别试验分成三个阶段(9个操作), 分别为按照word标识(TypInf)建立文章段落标识(第一阶段三个操作)、根据文章段落内容建立内容标识(第二阶段三个操作)、对目标段落进行数据识别定位并对数据置标, 根据数据标识和提取规则提取数据, 检查和清除有疑问的数据(第三阶段三个操作). 考虑到化学数据自动识别涉及大量的数据处理和存储需要, 软件使用微软的Access环境开发, 待处理的原始文献文本数据存放于PaperInf表单(外部数据), 在第一阶段PaperInf2文章段落操作后转入到文章段落表单, 完成第一阶段操作建立文章段落标识后的结果存放于置标文章段落表单, 其后所有操作使用的原始文本和结果文本均存放于置标文章段落表单.
现实中, 期刊文章由于作者或排版的原因会有一些影响化学数据自动识别的错误, 这些错误包括来自word文档的TypInf把小标题标识为正文, 或把正文或空行标识为小标题、小标题缺少序号或序号不连续、正文结束缺少句号等, 为此软件建立了问题报错机制, 并在某些操作前后增加进行人工检查的建议, 只要在对应的表单中添加更新要求, 后继处理程序会按照要求对前面的结果进行更新. 第一阶段第二个操作后建议检查文章段落_log表单中的标识置标类报错, 文章段落_log表单中的出错报告分为error、wrong、warning三个级别, 其中error表示此错误影响后继处理和最终结果, wrong表示此错误影响本阶段处理结果但不影响最终结果, warning表示此错误不符合规范但不影响处理结果. 本阶段错误通常与来自word的TypInf有关, 可以使用 “原文@更正文”句式让后继程序对原文进行必要的修正; 第二阶段第一个操作前建议进行与更正作者笔误有关的检查, 具体更正要求可以用“原文@更正文”句式写入置标文章段落表单的FixAuthMistake字段中; 第二阶段第一个操作后建议检查文章段落_log表单中的内容置标类报错, 这类错误主要为正文结束缺失句号; 第二阶段第二个操作后建议检查表单中的段落分类结果, 表单中列出了所有文章分类(综述文章、实验研究文章、非实验研究文章)和小标题名称及内容分类, 可以根据需要人为指定文章的类型和下属小标题内容分类, 以备后续程序对结果进行更正; 第三阶段第二个操作后建议检查产物信息表单中的产物名称, 标记有问题的结果以方便后继的数据利用. 对于因作者笔误导致的数据识别定位错误, 可以用“原文@更正文”句式将更正要求写入置标文章段落表单该段落对应的FixAuthMistake字段, 再次执行第三阶段第一个操作, 即得到更正后的数据识别定位结果. 鉴于有机化学实验部分的语言表达特点可供利用和英文化合物名称自动识别方法尚未建立, 本方法中的产物名称识别使用局部场景限制(限于产物数据内容段)和不相关内容排除法, 对2022年《有机化学》期刊文章中产物名称识别结果进行人工审核, 正确率超过98.5%. 中英文实验部分内容在化学数据自动识别过程各阶段的标识变化情况见图7.


3 结果与讨论
使用语言表达模式和基于规则的自然语言处理方法, 完成了2013~2022年10年的《有机化学》期刊3275篇含实验部分的文章中化学数据的自动识别提取, 提取的数据包括产物特性(产物名称、产物代号、CAS号、分子式、分子量、元素分析)、合成反应参数(反应温度、反应时间、纯度、产率、分离方法)、物性数据(熔点、沸点、性状、溶解度、旋光、晶体参数、磁化率)、谱学数据(红外光谱、紫外光谱、荧光光谱、1H NMR、质谱、13C NMR、31P NMR、19F NMR、11B NMR、29Si NMR、15N NMR、氢异核多碳相关谱、穆斯堡尔谱、圆二色谱), 提取的数据经过处理建成对应的数据库(1287 Mb), 已经开始对外提供《有机化学》期刊知识服务[15].
以2022年《有机化学》期刊的全部422篇文章为例进行了自动识别方法的性能测试, 在双核单CPU 1.6 GHz, 内存2 GB, 运行windows XP的ThinkPad便携机上, 总需时不超过22 min(不包括建议的人工检查), 各个操作的需时情况为: PaperInf2文章段落<1 min, 原文TypIn标识检查<2 min, 基于标识的段落置标5 min, 基于内容的段落置标<2 min, 文章段落分类结果检查<1 min, 更新内容置标和段落分类<1 min, 数据分析定位及置标10 min, 结果数据提取<2 min, 清除有疑问的产物数据<1 min. 本方法理论上对于旋光、熔点、红外谱图、核磁谱图、质谱等具有起始标识数据的识别提取正确率可以达到100%, 而在实际应用中由于存在非规范表达和作者笔误, 数据识别提取的正确率有所下降. 对2022年《有机化学》期刊的全部422篇文章的数据识别提取结果检查表明, 旋光数据识别提取的正确率为100%, 熔点数据识别提取的正确率为99.85%, 氟核磁谱识别提取的正确率为99.55%, 有2例作者将19F NMR写成了9F NMR; 碳核磁谱识别提取的正确率为99.80%, 有作者将13C NMR写成了3C NMR、13C{1H}, 也有的碳核磁谱缺少结束符“.”. 对于完全由文字组成的数据, 由于数据边界的确定有一定难度, 识别提取的正确率会稍低一些, 例如形态数据由于没有把viscous、oiliness、needles、block作为物质形态用词, 识别提取的正确率为99.47%(包括有作者笔误将solid写成了soild). 对于同为全文字数据的产物名称, 共提取了4665个产物名称, 其中有问题的产物名称58个, 识别提取的正确率为98.76%. 本工作于2023年3月完成. 由于《有机化学》期刊文章有中文和英文两种类型, 当时中文化合物系统半系统命名模式还未建立, 而英文化合物系统半系统命名模式研究还未开始, 产物名称的自动识别定位使用了基于(产物数据、产物性质)局部场景的无关内容排除法, 如果将来使用化合物系统半系统命名模式, 产物名称的自动识别定位准确率有望进一步提高.
用2021年《有机化学》期刊的2篇中英文文章(DOI号为10.6023/cjoc202008045, 10.6023/cjoc2020)对Chem-DataExtractor的性能进行了初步测试. 英文文章10.6023/cjoc202008045实验部分共有21个产物(3a~3u)、21个氢核磁谱、19个碳核磁谱、21个磷核磁谱、21个高分辨质谱、21个性状、21个熔点和21个产率; ChemDataExtractor给出了其中11个产物(3a、3c、3e、3i、3j、3k、3n、3o、3p、3q、3t), 以及所有的氢核磁谱、碳核磁谱和磷核磁谱, 但是氢核磁谱和碳核磁谱的谱峰数目均不超过4个, 存在明显的谱峰丢失; 中文文章10.6023/cjoc202007046实验部分共有24个产物(3a~3x)、24个氢核磁谱、24个碳核磁谱、2个高分辨质谱、24个性状、8个熔点和24个产率, ChemDataExtractor给出了其中3个产物(3q、3l、3s), 20个氢核磁谱和18个碳核磁谱. ChemDataExtractor方法的主要问题是产物/化合物数据丢失严重, 出的氢核磁谱和碳核磁谱内容不完整, 以及不能识别高分辨质谱、性状、产率和熔点数据.
从2021年《有机化学》期刊中随机抽取了5篇文章(DOI号为10.6023/cjoc202008041, 10.6023/cjoc2020 08045, 10.6023/cjoc202006054, 10.6023/cjoc202007046, 10.6023/cjoc202008044)用阿里巴巴的通义千问生成式大模型进行数据识别提取试验, 对其中的10.6023/cjoc202007046进行了3次重复试验, 得到三个不同的结果. 此文共有24个产物名称, 三次试验分别得到9个、13个和12个产物名称. 试验结果显示生成式大模型存在一些共性问题: (1)存在数据丢失现象, 平均丢失率超过50%. 例如10.6023/cjoc202006054共有22个产物名称, 通义千问只给出其中4个产物名称. (2)某些数据(如分子式)的提取结果存在无中生有(幻觉)和移花接木现象. 例如10.6023/cjoc202008044原文均未提供产物的分子式数据, 通义千问的结果为每个产物都提供了分子式数据. 检查发现部分分子式来自高分辨质谱数据中的分子离子峰对应的分子式, 而在产物没有提供高分辨质谱数据情况下则是一种无中生有的幻觉现象. 再如化合物6a原文产率为56%, 通义千问给出的结果为56% (24 h)/23% (3 h), 第二个产率23%来自结果与讨论部分中其他文献数据的引用. (3)一些数据的提取存在数据不完整和数据选择错误. 例如6a的质谱数据原文为HRMS (ESI) calcd for C30H20O2Na (M+Na)+ 435.13610, found 435.13646. 通义千问给出的质谱数据是计算值435.13610. 上述问题中幻觉现象源自生成式大模型使用的统计概率方法, 有一些研究者已经在探索使用探针、预处理或后处理的方法解决幻觉问题, 但要完全解决还有一段距离, 而数据丢失和数据选择错误的问题可能与通用生成式大模型针对这类数据的训练不足有关.
基于语言表达模式和规则的自然语言处理的数据自动识别方法只要求定义目标数据的语言表达模式与具体的学科和领域无关, 因此逻辑上适合所有类型科学数据的自动识别提取. 方法对算力的要求不高, 普通的便携机和台式机就能满足算力要求, 遇到例外情况时, 只需修改语言表达模式和对应的正则表达式, 即可完成针对例外情况的修改完善. 方法将科学数据的语言表达模式直接转换成正则表达式用于数据的识别定位, 全面准确地执行了语言表达模式的定义和要求, 因此对文本中符合语言表达模式的数据识别正确率接近100%, 但是对文本中不符合语言表达模式的数据的识别正确率为0%.
科技文献中科学数据识别的完整过程上可以分为数据识别、实体识别、数据与实体关系识别三个步骤. 鉴于有机化学实验部分的语言表述特点, 即数据与数据对应实体都在同一个内容段, 无需进行数据与实体关系识别, 本研究仅完成了数据识别方法和实体识别中的中文化合物系统和半系统命名识别方法. 剩下的实体识别中的英文化合物系统和半系统命名识别方法, 以及数据与实体关系识别方法将在后续的研究中解决.
(Cheng, F.)