研究论文

乙醇高值转化制正丁醇的机器学习研究

  • 张宇明 ,
  • 孙世涛 ,
  • 周诗嘉 ,
  • 李珺卿 ,
  • 贺雷 , * ,
  • 王东琪 , *
展开
  • 大连理工大学精细化工国家重点实验室 辽宁省碳资源催化转化重点实验室 大连市智能化学重点实验室化工学院化学学院 大连 116024

收稿日期: 2026-04-06

  网络出版日期: 2026-06-22

基金资助

国家自然科学基金(U23A20130)

辽宁省滨海实验室(LBLE-2023-04)

Value-added Transformation of Ethanol to n-Butanol: a Machine Learning Study

  • Yuming Zhang ,
  • Shitao Sun ,
  • Shijia Zhou ,
  • Junqing Li ,
  • Lei He , * ,
  • Dongqi Wang , *
Expand
  • State Key Laboratory of Fine Chemicals, Liaoning Key Laboratory for Catalytic Conversion of Carbon Resources, Dalian Key Laboratory of Intelligent Chemistry, School of Chemical Engineering, School of Chemistry, Dalian University of Technology, Dalian 116024, China
*E-mail: ;

Received date: 2026-04-06

  Online published: 2026-06-22

Supported by

National Natural Science Foundation of China(U23A20130)

Liaoning Binhai Laboratory(LBLE-2023-04)

摘要

将生物乙醇转化为正丁醇是实现可再生能源长期储存和高值化利用的重要路径. 从庞大的合成空间中获得高效正丁醇合成催化剂的传统试错方法耗时耗力, 效率低, 且难以涵盖大量的材料组合. 基于此, 本研究引入机器学习工作方法, 旨在探索以提高正丁醇收率为目标的催化剂筛选和设计的数据驱动研究范式. 本研究收集了2000年以来的乙醇催化转化制正丁醇反应的非均相催化研究文献数据, 构建了一个包含催化剂组成、制备方法、结构特性、反应条件及其相应催化性能的乙醇转化制正丁醇的催化剂数据集. 基于该数据集, 评估了九种重要的回归算法, 其中, 极端梯度提升回归(XGBR, eXtreme Gradient Boosting)模型的训练集的决定系数(R2)为0.986, 测试集为0.897, 展现出超越其他模型的预测性能和泛化能力. 结合贝叶斯优化算法, 在正丁醇合成催化剂参数空间中高效筛选出5组高性能候选催化剂, 为乙醇催化转化制正丁醇反应催化剂的高效筛选与理性设计提供了新的思路, 为乙醇高值高效利用开辟了数据驱动新途径.

本文引用格式

张宇明 , 孙世涛 , 周诗嘉 , 李珺卿 , 贺雷 , 王东琪 . 乙醇高值转化制正丁醇的机器学习研究[J]. 化学学报, 2026 , 84(9) : 1464 -1474 . DOI: 10.6023/A26040110

Abstract

The conversion of bioethanol to n-butanol represents a crucial pathway for the long-term storage and high-value utilization of renewable energy. Traditional trial-and-error approaches to obtain efficient catalysts for n-butanol synthesis from vast synthetic spaces are time-consuming, labor-intensive, and inefficient, while being incapable of covering extensive material combinations. This study introduces machine learning methodologies to explore a data-driven research paradigm for catalyst screening and design aimed at improving n-butanol yield. We collected literature data on heterogeneous catalysis for ethanol-to-n-butanol conversion since 2000, establishing a comprehensive catalyst dataset encompassing catalyst composition, preparation methods, structural characteristics, reaction conditions, and corresponding catalytic performance. Nine regression algorithms were evaluated based on this dataset, with the eXtreme Gradient Boosting (XGBR) model achieving coefficient of determination (R2) values of 0.986 and 0.897 for the training and test sets, respectively, demonstrating superior predictive performance and generalization capability compared to other models. Coupled with Bayesian optimization, five high-performance candidate catalysts were efficiently identified within the n-butanol synthesis catalyst parameter space. This work provides novel insights for the efficient screening and rational design of catalysts for ethanol-to-n-butanol conversion and opens a data-driven avenue for the high-value and efficient utilization of ethanol.

1 引言

人类社会的发展与进步依赖于能源的开发利用, 能源一直是推动社会进步、技术革新与经济发展的核心动力. 以煤炭和石油为代表的传统化石燃料始终占据着世界能源消费格局的主导地位, 其在全球一次能源消费中的占比始终维持在八成以上, 是维系现代工业正常运转的核心能源保障[1]. 我国的能源体系主要依赖煤炭, 而石油和天然气资源则相对不足. 随着能源需求的持续增长, 化石燃料的消耗量不断增加, 导致二氧化碳排放量屡创新高, 减碳形势日益严峻. 因此如何在安全性、经济性和低碳性之间实现平衡, 变得愈发重要.
生物质能源作为一种可持续性的能源形式, 具有环境友好性和可再生性. 在“双碳”目标指引下, 利用生物质能源生产清洁液体燃料以及高附加值化学品展现出巨大的发展潜力[2]. 目前, 以农作物秸秆、甘蔗等非粮经济作物和微藻为原料, 通过生物发酵技术实现生物乙醇的大规模生产[3]. 生物乙醇产量呈逐年增长趋势, 2024年全球的生物乙醇产量约为9300万吨, 其中中国生物乙醇产量约370万吨[4]. 作为重要的平台化合物, 生物乙醇不仅可以用作燃料乙醇, 与化石燃料混合使用以减少温室气体排放并降低我国对进口石油的依赖; 还可以进一步通过脱氢、C—C偶联、芳构化等催化转化技术升级为正丁醇等高附加值精细化学品[5-7].
正丁醇作为一种基础精细化工原料, 能用于制备邻苯二甲酸二丁酯、丙烯酸丁酯以及醋酸丁酯等塑料与橡胶助剂的生产, 此外, 该物质可作为萃取剂提取油脂、抗生素、维生素和香料, 能够作为添加剂配制醇酸树脂涂料, 还能充当有机染料及印刷油墨的溶剂与脱蜡剂[8]. 此外, 正丁醇能与汽油任意比例互溶、且对现有发动机和管路无腐蚀性, 这一特性使其作为发动机燃料更具优势. 正丁醇的能量密度达到29.2 MJ•L−1, 与传统汽油(32.5 MJ•L−1)相近, 却明显高于乙醇(19.6 MJ•L−1). 这意味着同等体积下正丁醇可释放更多能量, 从而提升燃料经济性并延长行驶里程. 同时, 该醇的蒸发热为0.43 MJ•L−1, 只有乙醇(0.92 MJ•L−1)的一半, 与汽油(0.36 MJ•L−1)相当接近, 这赋予其优良的低温启动性能. 基于以上优点, 正丁醇被视作下一代生物燃料添加剂的首选, 具有作为汽油替代品的潜力[9]. 同时, 正丁醇作为生物燃料使用时, 可以显著削减硫氧化物(SOx)、氮氧化物(NOx)、粉尘颗粒以及温室气体的排放, 具有明显的环境友好性, 生态效益突出.
目前, 生产正丁醇的主要生产方法包括生物发酵法、乙醛缩合法和羰基合成(OXO)法. 生物发酵法生产效率低[10], 乙醛缩合法设备腐蚀严重, 生产成本高, 产能受限, 已逐渐被工业应用所淘汰[11]. 羰基合成法是工业生产高碳醇的主要方法, 但羰基合成法催化剂价格昂贵、反应条件苛刻、工艺路线长[12]. 在碳中和目标的推动下, 以乙醇为原料经过Guerbet反应合成正丁醇, 被认为是一条可持续的生物燃料合成途径, 具有工艺流程短、反应过程清洁和生产成本低等特点, 符合“绿色化学”的要求[13]. 乙醇转化制正丁醇催化剂需要具备脱氢/加氢、羟醛缩合以及脱水等多功能活性位点. 催化体系可分为均相催化体系和非均相催化体系.
在均相催化过程中, 使用Ir[14-16]、Ru[17-18]或Mn[19]络合物作为催化剂, 脱氢或加氢活性位点由含贵金属的配合物催化剂提供, 羟醛缩合反应则在乙醇钠或其他强碱性溶液提供的碱性环境中进行[20]. 近年来, Kulkarni等[21]开发了以Mn钳形配体为催化剂的均相非贵金属催化剂, 用于催化乙醇转化制正丁醇, 正丁醇选择性超90%. 尽管均相催化剂体系中可以得到较高的总醇选择性, 但催化剂的高昂成本和难以回收的特性限制了其在乙醇大规模制备正丁醇中的实际应用. 此外, 反应体系中的强碱环境也会对反应器造成腐蚀, 进一步增加了成本.
相比之下, 非均相催化剂通常以固体形式存在, 其合成工艺较为简单, 易于从反应体系中分离并实现多次重复使用, 从而降低了催化剂的使用成本. 此外, 非均相催化剂自身的酸性位点和碱性位点可以作为C—C偶联的活性位点, 因此无需引入碱性溶液即可实现乙醇的高效转化. 目前, 多相催化剂已在连续固定床反应器和间歇反应器中广泛研究. 近年来, 具有邻近Lewis酸、碱位点的固体酸碱催化剂, 如镁铝混合氧化物[22-23]以及羟基磷灰石[24-25]等, 逐渐被用于乙醇转化制正丁醇反应的研究中. 为了增强固体酸碱催化剂在乙醇脱氢和中间体加氢过程中的活性, 弥补其自身较弱的脱氢与加氢能力, 研究人员发现可通过在催化剂表面引入贵金属(Ru、Pt、Ag等)[26-28]或非贵金属(Ni、Co、Cu、Zn等)[29-34]来实现. 这一策略还有助于提高C—C偶联速率, 从而提升整体催化效率. 对于一些常见的催化剂载体, 如Al2O3[35-37]、CeO2[38-39]、脱铝Beta分子筛[40-41]等, 通过引入碱性氧化物(如La2O3、MgO等)和过渡金属制备的负载型金属氧化物催化剂, 也在乙醇转化制正丁醇反应中表现出反应活性. 此外, 金属有机框架(MOF)材料[42-44]和活性炭(AC)[45-46]等也被报道用于乙醇偶联制正丁醇反应.
目前, 生物质衍生乙醇作为平台分子制备正丁醇技术仍处于实验室探索阶段. 由于催化剂的结构特征与其催化性能之间存在极为复杂的内在关联, 加之乙醇转化制高碳醇反应本身存在多种反应机制, 导致当前该体系催化剂的研发工作仍主要依赖传统的经验型试错策略. 在乙醇转化制高碳醇的催化剂研发过程中, 候选催化组分的元素种类、载体类型繁多, 且各组分的含量可调范围宽泛, 随着组分数量的增加, 需要探索的催化剂组成空间呈现指数级增长趋势. 传统试错法不仅研发效率低下, 无法快速筛选出最优催化体系, 还会导致研发成本大幅攀升, 难以满足工业化研发的需求. 近年来, 人工智能技术的迅猛发展为催化领域的研发工作提供了全新的研究范式[47-48], 为解决传统研发方法的弊端开辟了新路径. 其中, 以机器学习为核心的人工智能技术具备强大的数据挖掘、归纳与分析能力, 能够充分挖掘并利用研发过程中积累的大量实验数据及理论计算数据, 从中提炼催化反应规律, 精准识别影响催化剂性能的关键因素, 深入揭示催化剂特征参数对催化反应过程的作用机制, 进而指导高性能催化剂的高效、低成本开发[49-51].
机器学习技术的有效应用高度依赖于训练数据的数量和质量[52]. 近年来高通量实验和计算能力的进步加速了催化剂数据的获取[53]. 此外, 文献数据挖掘也是获取数据的有效手段之一. 通过分析学术文献, 可以获得丰富的信息, 为机器学习模型的训练提供有价值的数据[54-56]. Li等[57]通过从100篇已发表的关于将二氧化碳固定成环状碳酸盐的金属有机框架(MOFs)的论文中收集的数据训练了机器学习模型, 并进一步确定了几种具有强大催化能力的候选者. Dong等[58]通过挖掘相关文献数据, 训练了高精度机器学习预测模型, 预测了高时空产率(Space Time Yield, STY)多元素氧化物甲醇合成催化剂.
迄今为止, 关于乙醇催化转化制正丁醇反应的大量实验数据已发表, 但目前尚无基于该反应的数据驱动的研究被报道. 为了加速高效乙醇催化转化制正丁醇催化剂的开发, 本研究调研了2000年1月至2024年12月期间使用生物质衍生乙醇作为平台分子制备正丁醇的文献, 构建了一个乙醇催化转化制正丁醇的数据集, 并将该数据集用于训练候选乙醇催化转化制正丁醇催化剂组成及其对应的预处理和反应条件特征的预测模型. 研究进而采用Shapley加性解释(SHAP)[59]方法对模型预测结果中的各特征的贡献进行可解释性分析, 以深入理解催化过程, 为该领域研究人员提供了宝贵的见解.

2 结果与讨论

2.1 数据分析

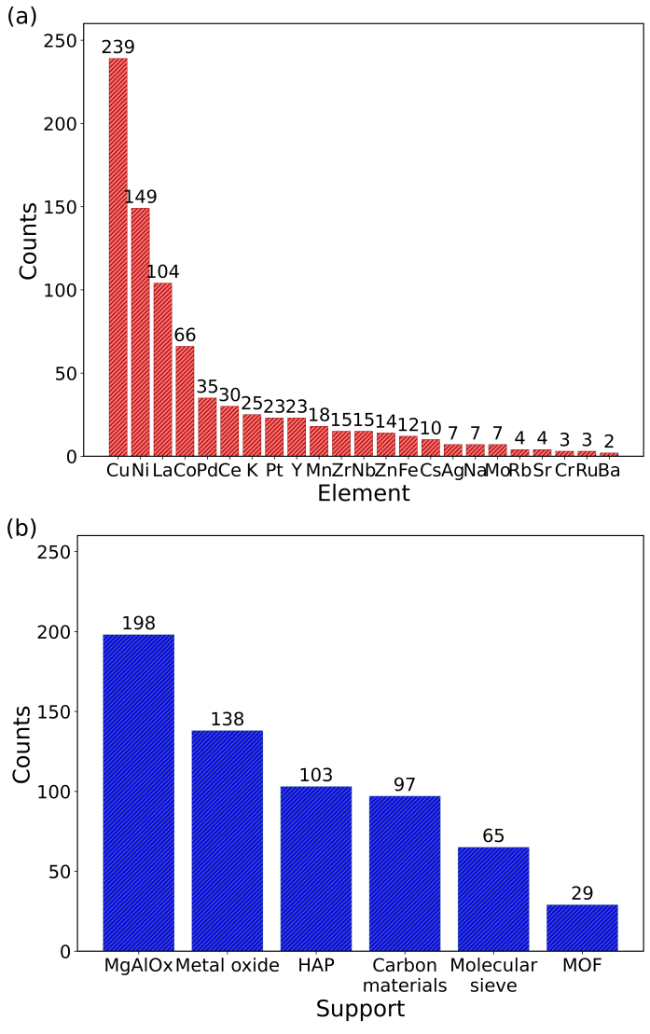
为了直观地展示数据集中数据的分布, 催化剂负载的主要活性金属种类的统计数据以及催化剂载体类型的统计数据显示在图1中. 其中基于Cu、Ni、La和Co为主要活性组分的催化剂是文献中报道最多的乙醇催化转化制正丁醇非均相催化剂(图1a), 而最常用的载体是镁铝水滑石(MgAlOx)(图1b).
图1 数据集中催化剂组分分布: (a)主要活性金属; (b)载体种类

Figure 1 Distribution of catalyst components in the dataset: (a) major active metals; (b) types of support materials

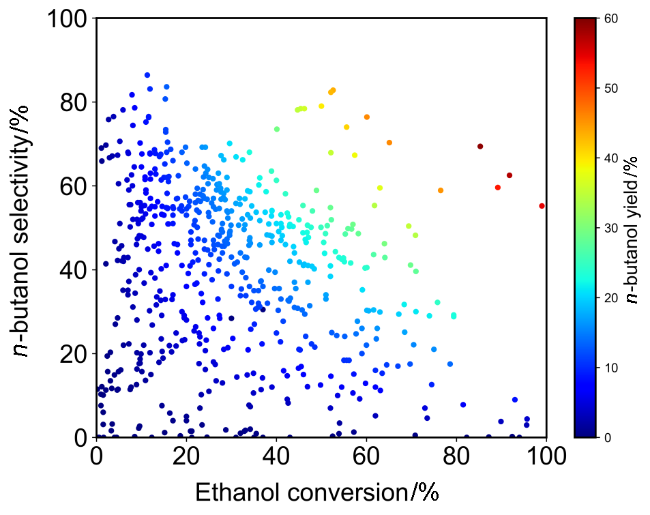
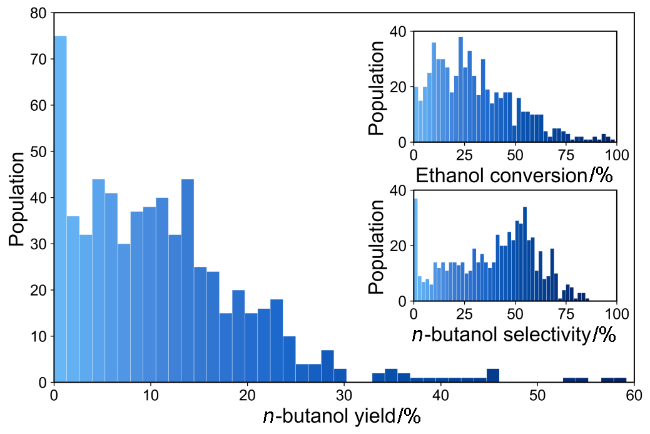
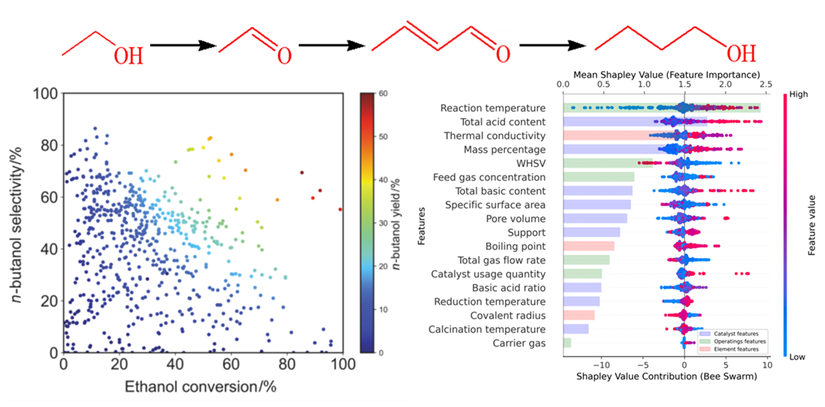
描绘乙醇转化率、正丁醇选择性和收率关系的散点图绘制在图2中. 在低转化率区间(<40%)内, 正丁醇选择性随乙醇转化率缓慢上升, 两者之间呈现弱正相关, 此时正丁醇收率偏低. 在中转化率区间(40%~60%)内, 正丁醇选择性和乙醇转化率之间无明显相关性, 但正丁醇收率随转化率快速上升, 呈现正相关趋势. 在高转化率区间(>60%)内, 正丁醇选择性随乙醇转化率明显下降, 呈现显著负相关. 由此可见, 乙醇转化率、正丁醇选择性和正丁醇收率三者间的相关性复杂多变, 并非是单一的线性相关性, 表明乙醇转化制正丁醇催化体系具有较高复杂性. 此外, 正丁醇收率分布(图3)表明, 数据呈现长尾不平衡分布, 85%的数据分布在0~30%收率区间, 15%在30%~60%收率区间. 大量数据分布在乙醇转化率较低且正丁醇选择性中等至较高的区域. 这表明, 目前大部分催化体系仍处于低效区, 需要开发在活性与选择性之间实现更优平衡的催化剂以提高收率.
图2 由乙醇转化率、正丁醇选择性和正丁醇收率组成的散点图(收率随数值大小由不同颜色表示)

Figure 2 A scatter plot of ethanol conversion rate, n-butanol selectivity, and n-butanol yield (where yield values are represented by different colors according to their magnitude)

图3 数据集中催化剂性能的分布直方图

Figure 3 Histogram of catalyst performance distribution in the dataset

2.2 数据预处理和特征选取

在正丁醇合成催化反应中, 乙醇的单程转化率、正丁醇的选择性、正丁醇的收率等均可作为评价催化剂性能的指标. 由于本研究的数据集主要来源于已公开发表的相关学术文献, 受文献数据记录完整性的限制, 部分样本存在部分特征指标缺失的现象(占比约12%~15%). 尽管此类样本的特征信息不够完整, 但其中包含的有效数据对催化剂的研发设计仍具有重要的参考与指导意义. 在机器学习领域, 缺失值的常规处理方式多为简单赋值填充, 例如以0值、特征均值或中位数直接替代缺失数据, 但这种简单的填充方式对于催化剂样本而言, 极易与样本的真实特征数据产生较大偏差, 进而干扰模型的训练过程, 降低模型的预测准确度. 因此, 针对数据集中部分催化剂样本在比表面积、孔容、碱酸比、重时空速等关键特征上的数据缺失问题, 本研究摒弃传统简单填充方法, 依托数据集中已有的完整样本信息, 采用基于模型的预测性填充策略, 对缺失数据进行精准补全, 最大限度保留样本的真实特征信息[58].
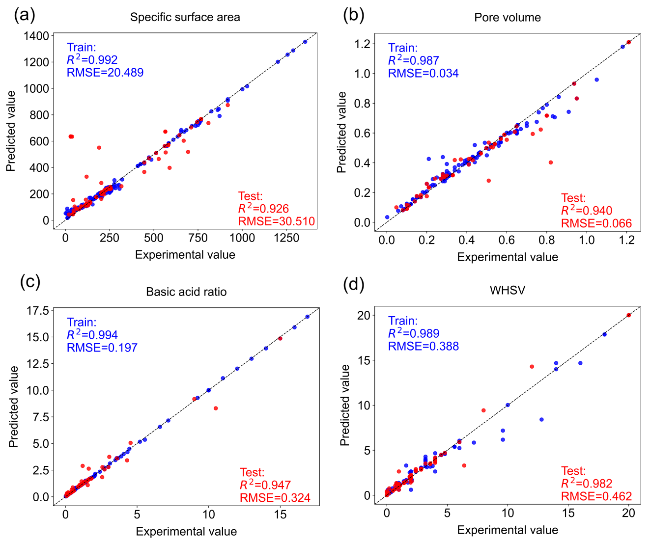
极端随机树(Extremely-randomized Trees Regression, ETR)回归算法被用于构建催化剂特定特征缺失值的预测模型, 该模型能够有效捕捉特征与目标值之间的非线性关系[60]. 如图4所示, 针对催化剂比表面积这一关键特征, ETR预测模型在训练集上的决定系数(R2)达到0.992, 均方根误差(RMSE)为20.489 m2•g−1, 在测试集上R2为0.926、RMSE为30.510 m2•g−1; 对于催化剂孔容特征, 该模型在训练集上R2为0.987、RMSE 为0.034 cm3•g−1, 测试集上R2为0.940、RMSE为0.066 cm3•g−1. 在催化剂碱酸比与重时空速特征的预测中, ETR模型同样展现出优异的性能: 碱酸比预测模型在训练集上R2为0.994、RMSE为0.197, 测试集上R2为0.947、RMSE为0.324; 重时空速预测模型在训练集上R2为0.989、RMSE为0.388 h−1, 测试集上R2为0.982、RMSE为0.462 h−1. 无论是训练集还是测试集, ETR模型的预测值与样本实际观测值之间的偏差均处于合理可接受范围, 验证了该模型用于催化剂特征缺失值填充的可靠性与有效性. 因此, 对于数据库中缺少特定特征数据的实例, 这些经过良好训练的回归模型可以用来估计缺失的数据, 可用于训练催化剂性能预测模型的实例数量增加, 有利于提升预测准确性和模型的泛化能力.
图4 预测特定特征缺失值的ETR模型: (a)比表面积; (b)孔容; (c)碱酸比; (d)重时空速

Figure 4 ETR models for predicting missing values of specific characteristics: (a) specific surface area; (b) pore volume; (c) base-to-acid ratio; (d) gravimetric space velocity

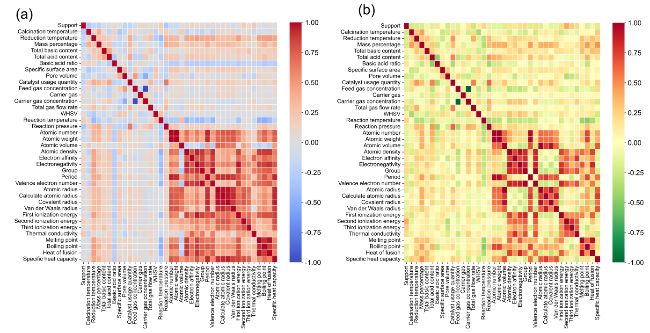
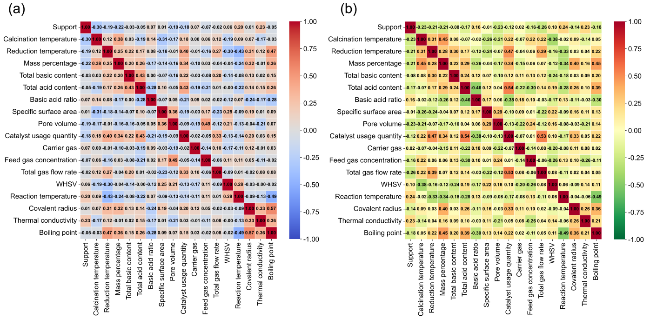
本研究采用正丁醇收率作为正丁醇合成催化剂的性能指标来构建预测模型. 因此, 将初始数据集中含有正丁醇收率数据的催化剂实例筛选出来构建新的数据集(Ⅰ), 包含630个催化剂实例. 由于催化剂的组成、结构、反应条件等因素均会对催化剂正丁醇收率产生影响. 因此, 为了分析这些特征之间的相关性, 基于数据集(I)进行了皮尔森相关性和斯皮尔曼相关性分析(图5), 筛查相关性强的特征, 避免信息冗余. 相关性分析表明, 催化剂的组成、制备条件、结构特征以及反应条件之间未呈现显著的相关性, 因此可以同时用于组建催化剂特征向量. 然而, 催化剂组成元素的物理化学性质特征之间存在一定的相关性, 例如金属元素的原子序数和该元素所在的周期之间的皮尔森相关性系数和斯皮尔曼相关性系数的绝对数值均接近1(本研究取皮尔森相关性系数和斯皮尔曼相关性系数的绝对数值大于0.75为强相关). 因此, 为消除信息冗余, 提升模型运算效率, 本研究基于“最大独立性”原则对这些特征进行了筛选, 即优先删除那些与其他多个特征存在强相关性的特征. 继而使用基于模型的特征重要性排序进行精筛; 最后结合化学机理人工审视, 剔除了缺乏催化解释力或高度冗余的特征. 如图6所示, 最终从38个特征中筛选出18个作为模型的输入, 其中包含15个实验特征和3个物理化学性质特征(共价半径、热导率和沸点), 该数据集定义为数据集(II).
图5 所有输入特征之间的相关性分析: (a)皮尔森相关性; (b)斯皮尔曼相关性

Figure 5 Correlation analysis among all input features: (a) Pearson correlation; (b) Spearman correlation

图6 筛选后特征之间的相关性分析: (a)皮尔森相关性; (b)斯皮尔曼相关性

Figure 6 Correlation analysis between screened features: (a) Pearson correlation; (b) Spearman correlation

2.3 正丁醇合成催化剂的收率预测模型构建与模型性能评估

数据集中数据的分布对模型的准确度、收敛速度及泛化能力具有决定性影响. 如图3所示, 数据库中大多数催化剂实例的正丁醇收率低于20%, 少数样本分布在20%至60%区间中. 数据集存在数值分布跨度大且局部区域样本稀疏的特点, 直接采用简单随机抽样进行训练集和测试集划分, 易导致抽样样本集中在某一数值区间, 从而破坏模型对低值或高值样本的拟合准确度, 引发局部过拟合问题. 因此, 本研究将分层抽样策略应用于训练集和测试集划分. 我们首先将数据集(II)按正丁醇收率的数值区间进行分层, 再将数据库中80%的实例选择作为训练集, 其余20%被用作测试集, 选用九种重要的监督回归模型来构建预测模型并通过网格搜索和10折交叉验证方法进行超参数优化以提升模型预测准确度.
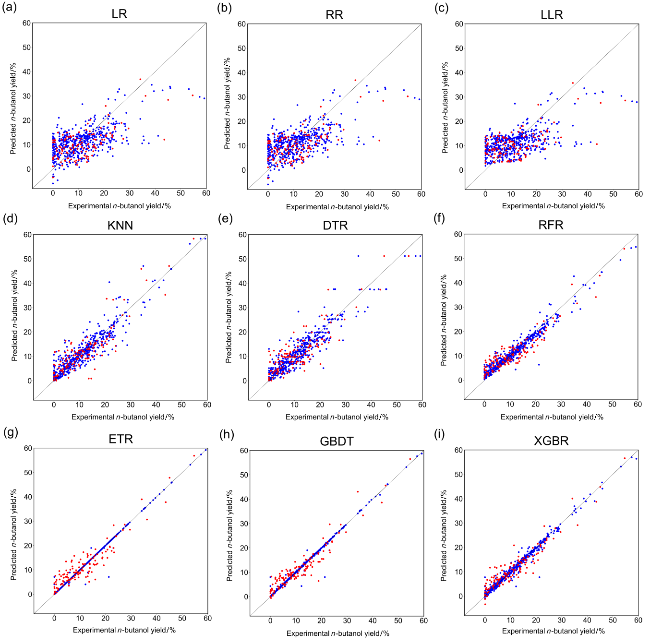
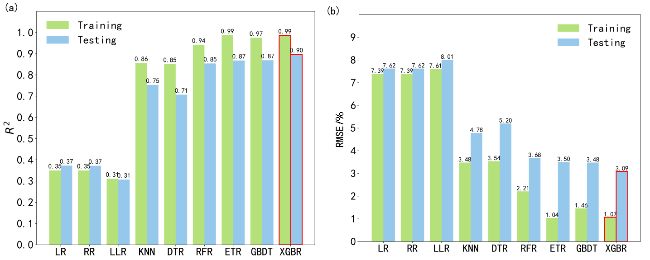
在本研究中, 我们选择R2和RMSE值作为评估指标, R2接近1, RMSE接近0代表理想的模型预测能力. 表1、图7和图8展示了九种监督回归模型的预测准确度评估结果. 在这九种回归模型中, 线性回归以及基于其正则化改进的岭回归和套索回归模型均未表现出良好的预测准确性. 三者的预测准确度十分接近, 在训练集和测试集上的R2值均小于0.5, 难以满足实际预测需求. 据此可以判断, 本节中所研究的目标特性(正丁醇收率)与特征参数之间不具备显著的线性映射关系.
表1 不同机器学习算法回归结果对比

Table 1 Comparison of regression results for different machine learning algorithms

ML model R2-train R2-test RMSE(%)-train RMSE(%)-test
LR 0.350 0.373 7.39 7.62
RR 0.350 0.372 7.39 7.62
LLR 0.311 0.307 7.61 8.01
KNN 0.856 0.753 3.48 4.78
DTR 0.851 0.707 3.54 5.20
RFR 0.942 0.854 2.21 3.68
ETR 0.987 0.868 1.04 3.50
GBDT 0.975 0.869 1.46 3.48
XGBR 0.986 0.897 1.07 3.09
图7 不同机器学习模型的验证结果. LR: 线性回归; RR: 岭回归; LLR: 套索回归; KNN: K近邻回归; DTR: 决策树回归; RFR: 随机森林回归; ETR: 极端随机树回归; GBDT: 梯度提升回归; XGBR: 极端梯度提升回归

Figure 7 Validation results of different machine learning models. LR: Linear Regression; RR: Ridge Regression; LLR: Lasso Regression; KNN: K-Nearest Neighbor; DTR: Decision Tree Regression; RFR: Random Forest Regression; ETR: Extremely-randomized Trees Regression; GBDT: Gradient Boosting Decision Tree; XGBR: eXtreme Gradient Boosting Regression

图8 不同机器学习模型的预测准确度评价: (a)模型的决定系数, R2; (b)模型的均方根误差, RMSE (%)

Figure 8 Evaluation of prediction accuracy for different machine learning models: (a) Model coefficient of determination, R²; (b) Root mean square error, RMSE (%)

相比于上述三种模型. K近邻回归模型作为基于实例的学习方法的典型代表, 其在训练集和测试集上的R2分别为0.856和0.753, RMSE分别为3.48%和4.78%. 此外, 随机森林回归、极端随机树回归、梯度提升回归和极端梯度提升回归等集成模型也展现出较高的预测准确度. 在这些集成模型中, XGBR模型的训练集的R2和RMSE 分别为0.986和1.07%, 测试集上的值分别为0.897和3.09%, 其表现优于其他模型, 归因于基于树的机器学习模型在处理数据集中构建的广泛标签编码的固有优势.

2.4 模型可解释性分析

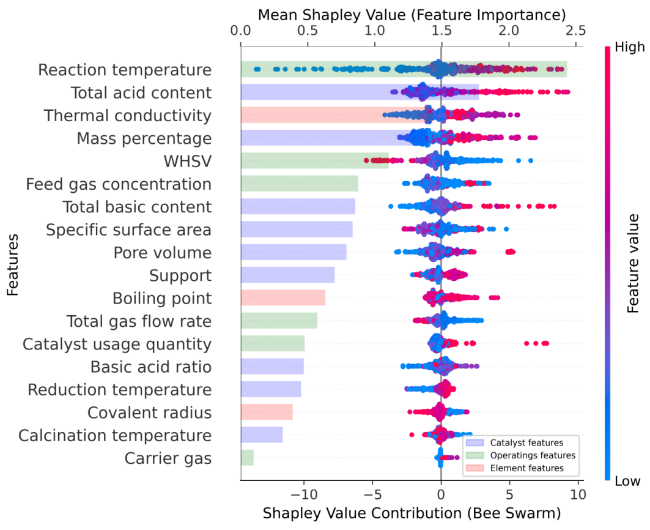
模型的可解释性分析对于揭示催化剂性能的影响因素、指导催化剂的理性设计具有重要意义. SHAP分析将预测值分解为各特征值贡献的加性和. 通过按降序对评估特征的重要性进行排序, 该方法阐明了每个特征对目标属性预测的重要性. 从上到下的顺序表示特征对正丁醇收率的相对贡献的大小, 贡献越大则特征的排序越靠上. 图中每一个点均代表一个样本点, 颜色为对应特征参数具体取值的大小. 横轴上的Shapley value contribution值代表着每个特征对于模型输出的贡献程度, 如果一个样本点的SHAP值为正, 则表示该特征取该值时增加了正丁醇收率(高于基准值); 同样, 如果一个样本点的SHAP值为负值, 则表示与基准值相比, 该特征取该值时降低了正丁醇收率. 按图9中的显著性排序. 这些特征包括: (i)反应条件特征, 即反应温度、重时空速、进料乙醇的浓度、总流速和催化剂质量; (ii)催化剂组分和结构特征, 包括金属的质量百分比、载体类型和酸碱位点含量、比表面积、孔容等结构表征; (iii)金属物理化学性质特征, 包括热导率、沸点和共价半径.
图9 通过SHAP分析得出的特征重要性(由上至下, 重要性依次减弱)

Figure 9 The feature importance derived from SHAP analysis (from top to bottom, importance decreases progressively)

2.4.1 催化反应条件贡献分析

催化反应的反应条件等会影响催化剂的表观反应性能. 其中, 反应温度的特征重要性得分最高, 为所有特征中最重要的影响因素, 其Shapley value contribution值贡献分布最宽, 正贡献(提升收率)与负贡献(抑制收率)均显著. 低温区间(蓝色点)表现为负贡献, 表明温度不足时乙醇脱氢、C—C偶联等基元反应速率受限, 正丁醇生成效率较低; 中高温区间(红色点)表现为强正贡献, 说明适度升温可加速乙醇脱氢生成乙醛中间体, 促进羟醛缩合与加氢脱氧步骤, 是促进正丁醇生成的关键驱动力. 但过高温度可能引发乙醇过度裂解、积碳等副反应, 导致收率回落. 重时空速(Weight Hourly Space Velocity, WHSV)与模型预测结果呈负相关关系, 表明过高空速会缩短反应物与催化剂的接触时间, 导致乙醇转化不完全、中间产物无法充分转化为正丁醇; 而适宜的低空速可延长接触时间, 促进多步串联反应进行, 提高正丁醇选择性. 原料气乙醇浓度主要表现为负贡献, 过高的乙醇分压易引发分子间脱水生成乙醚等副产物, 同时加剧在催化剂活性位点表面上的吸附竞争, 抑制C—C偶联反应. 由此可见, 适度降低原料气乙醇浓度可优化反应物在活性位点的吸附构型, 提升目标产物(正丁醇)的反应选择性. 总气体流速、催化剂的用量和载气种类特征重要性较低, 且未发现明显趋势, 这可能归因于载气种类对反应的影响主要体现在气氛调控与传质效率上, 需结合具体催化剂体系进一步解析.

2.4.2 催化剂特征贡献分析

催化剂的组成、结构、形貌等因素对催化剂的本征反应性能具有重要影响, 其中催化剂总酸含量为催化剂结构中最重要的指标, 对正丁醇收率有正向贡献. 酸性位点是乙醇脱氢、C—C偶联与脱水反应的活性中心, 适量的Brønsted酸与Lewis酸可协同促进乙醇脱氢生成乙醛与羟醛缩合步骤, 提升正丁醇收率; 但过量酸性位点易引发乙醇过度脱水、异构化等副反应, 表明催化剂表面的总酸含量需达到合适范围. 金属的质量百分比以正贡献为主, 表明催化剂活性组分负载量需处于适宜区间, 过低则活性位点不足, 过高则易发生团聚导致比表面积下降、副反应增多. 催化剂总碱含量正负贡献并存, 碱性位点可促进乙醇脱氢生成乙醛, 同时抑制酸性过强引发的副反应; 但过量碱性位点会中和酸性活性中心, 导致C—C偶联反应活性下降, 体现出酸碱协同的关键作用. 催化剂的比表面积和孔容对正丁醇收率的影响没有明显趋势. 这可以归因于催化剂的高比表面积可提供更多活性吸附位点, 促进乙醇的扩散与正丁醇的脱附, 以达到提升反应效率的目的; 但过高比表面积可能伴随孔道结构紊乱, 加剧扩散阻力, 降低传质效率.

2.4.3 金属组分特征贡献分析

金属的热导率是金属元素本征热物理性质的核心要素, 与其对电子束缚能力密切相关. 在本研究中, 该特征表现为强正向贡献, 是元素本征特征中对正丁醇收率影响最显著的变量. 乙醇催化转化制正丁醇为放热反应体系, 高导热性金属活性组分可快速导出反应过程中释放的热量, 避免催化剂局部过热引发的积碳, 同时维持活性中心的结构稳定性与电子性质均一性. 反之, 低导热性金属活性组分会导致反应热累积, 加剧催化剂失活与副反应发生, 显著降低正丁醇选择性与收率. 金属元素的沸点作为本征热力学性质, 对正丁醇收率的影响较为复杂, 未发现明显趋势. 这可能是高沸点金属在催化剂煅烧、还原等制备过程中更易发生团聚与烧结, 导致活性组分分散度下降、活性位点数量减少; 同时, 低沸点金属与载体的强相互作用会改变活性中心电子云密度, 降低乙醇脱氢、C—C偶联等关键反应步骤的催化活性. 元素共价半径作为本征几何与电子结构参数, 虽然其特征重要性在所有特征中排序靠后, 但其依然对乙醇Guerbet反应具有一定的指导意义. 金属的共价半径直接决定金属活性位点的空间位阻与电子云分布: 大共价半径金属会形成空间位阻, 阻碍乙醇分子与活性中心的吸附与过渡态稳定, 抑制脱氢与C—C偶联步骤; 同时, 大半径金属的电子云更弥散, 与反应物的相互作用减弱, 降低催化活性. 小共价半径金属则可提供更紧凑的活性位点, 优化反应物吸附构型, 促进目标反应进行. 上述SHAP分析结果表明高沸点高热导率金属元素可在制备中保持结构稳定, 小共价半径金属可以在反应中提供更为紧凑的活性位点, 因此, 通过设计一种高热导率载体负载小半径活性金属的催化剂, 并协同优化反应操作工况(如反应温度、WHSV等), 有望实现乙醇向正丁醇的高效转化.

2.5 高性能正丁醇合成催化剂的预测

为探索开发高性能正丁醇合成催化剂, 基于前述构建并验证的XGBR模型, 本研究采用贝叶斯优化算法对高维合成参数空间的催化剂进行筛选预测. 研究以正丁醇收率为核心优化目标, 以催化剂活性金属组分、载体及反应条件为决策变量, 通过贝叶斯优化迭代搜索, 在庞大的合成空间中得到5组具有优异催化性能的模型预测候选催化剂(表2). 结果表明, 模型预测出的催化剂性能优于绝大多数文献报道(≤40%), 其中Au/MgAlOx催化剂在334 ℃反应温度下, 正丁醇收率达到57.1%.
表2 高性能正丁醇合成候选催化剂的模型预测结果

Table 2 Model prediction results for candidate catalysts for high-performance n-butanol synthesis

No. Metal Support Reaction temperature/℃ Butanol yield/%
1 Au MgAlOx 334 57.1
2 Ag NaX 322 53.9
3 Cu NC 344 51.1
4 Ca NC 332 48.7
5 Be NC 327 46.9
该筛选结果验证了“预测模型+贝叶斯优化”策略在催化剂开发中的有效性, 实现了从“盲目试错”到“定向筛选”的开发模式升级, 大幅缩短了开发周期、降低了实验成本.

3 结论

本研究提出了通过数据驱动方法来加速开发乙醇催化转化制正丁醇高性能催化剂的框架. 构建了包含催化剂组成、制备条件、结构特征、反应条件和催化性能的数据集. 基于催化剂成分固有物理化学性质, 开发了一种催化剂特征构造方法. 使用该数据集和特征构造方法, 评估了9种预测不同催化剂在乙醇转化为丁醇收率的机器学习模型, 包括线性回归、岭回归、逻辑回归、K近邻算法、决策树回归、随机森林回归、极端随机树回归、梯度提升决策树、极端梯度提升回归. 其中XGBR模型拟合效果最优, 训练集的R2和RMSE值分别为0.986和1.07%, 测试集上的值分别为0.897和3.09%. 基于该模型, 结合贝叶斯优化算法, 在正丁醇合成催化剂参数空间中高效筛选出5组高性能候选催化剂, 显著提升了正丁醇收率. 该方法可以快速准确地预测催化剂的正丁醇收率, 并通过可解释机器学习工具揭示影响催化性能的重要特征, 大大缩减筛选催化剂的时间和成本, 对乙醇催化转化制正丁醇催化剂的设计和筛选具有重要意义.
综上所述, 本研究为机器学习在乙醇催化转化制正丁醇中的应用提供了宝贵视角, 并建立了从文献数据到机器学习模型、文献数据中特征-活性关系识别、预测结果的可靠框架. 这一综合方法不仅能加速催化剂的发现, 还能优化预处理和反应条件特征, 从而推动乙醇转化工艺的更高效发展. 然而, 文献数据挖掘, 可能存在发表偏倚情况, 如高收率样本稀少, 当前的高收率结果仅基于模型预测与模拟优化得出. 因此, 将在后续工作中通过定向实验扩充高收率数据. 此外, 目前数据收集主要依赖人工提取. 近年来, 研究人员开发了自动数据提取方法(如基于大型语言模型(LLMs)的技术)以提高数据提取效率. 虽然该方法的准确性目前仍低于手动数据提取. 尤其是从图像中获取数据带来了进一步的挑战, 但随着算法的发展, 自动数据提取将成未来的趋势.

4 实验部分

本研究的策略包含五个阶段: (i)数据收集与预处理; (ii)特征向量构建; (iii)机器学习模型构建与评估; (iv)结合SHAP分析的模型可解释性分析, 以确定特征对预测值(正丁醇收率)的贡献; (v)将开发的极端梯度提升回归(XGBR, eXtreme Gradient Boosting)模型与贝叶斯优化结合迭代生成候选催化剂及其对应的预处理和反应条件.

4.1 数据收集和数据库构建

催化剂数据库是机器学习加速催化剂研发的重要基础资源. 本研究采用了Web of Science和Scopus等常用的文献检索工具. 综合输入“ethanol upgrading”、“n-butanol synthesis”、“C—C coupling”、“Guerbet”等关键词, 例如: 使用的检索式为TS=("ethanol upgrading" AND ("n-butanol" OR "butanol") AND ("catalyst" OR "catalytic"), 筛选出2000年至2024年乙醇催化转化制正丁醇的文献综述和实验文章. 文献中包含均相与多相催化体系. 相比之下, 多相催化剂可实现重复使用与回收, 具有更高的实际应用可行性. 基于数据完整性和可分析性, 从已发表的文献中收集了764条正丁醇合成多相催化剂的组成、制备条件、结构参数、反应条件和催化性能等数据. 实验描述符大致分为三类: (1)催化剂组成与结构特征, (2)制备条件, (3)反应条件. 催化剂成分的数据收集包括金属元素和载体种类, 及其含量(质量分数). 结构特征包含: 通过Brunauer-Emmett-Teller方法计算的催化剂比表面积SBET (m2•g−1), 孔容(cm3•g−1)等表面特性, 以及催化剂总碱含量(μmol•g−1), 总酸含量(μmol•g−1)和碱酸比等催化剂的酸碱特性. 在制备条件中, 包括催化剂的煅烧温度(℃)和还原温度(℃). 反应条件包括催化剂用量(mg)、温度(℃)、压力(MPa)、重时空速(h−1)和原料气乙醇浓度(体积分数)等特征. 实验描述符的详细信息见支持信息表S1.
此外, 催化剂组成元素的物理化学性质也可作为催化剂的特征, 包括: 原子序数、原子质量、原子体积、原子密度、电子亲和势、电负性、族、周期、价电子数、原子半径、计算原子半径、共价半径、范德华半径、第一电离能、第二电离能、第三电离能、热导率、熔点、沸点、熔化热和比热容(支持信息表S2). 由于这些性质特征是以催化剂金属元素的摩尔分数为权重构建的, 已包含了组成成分信息, 因此在特征选择过程中, 不再单独引入金属元素类型, 仅保留表S2中基于上述方法构建的性质特征.
由于不同文献间的实验条件、测量标准不一致, 为确保不同来源数据的统一性, 在数据采集与清洗阶段设置了严格的统一标准, 具体如下: (1)反应性能指标统一: 正丁醇收率统一按文献中报道的数值进行采集; 如原始文献仅报道选择性, 则根据转化率重新核算收率, 无法统一者予以剔除. (2)实验特征数据标准化: 以固定床反应器数据为主, 比表面积统一采用BET值, 孔容以氮气脱附值为准; 总酸量/碱量按NH3/CO2-TPD脱附量归一化为μmol•g−1, 碱酸比按脱附量比值计算; 对于不同文献中温度、压力、重时空速等反应参数记录至统一量纲. (3)重复数据去重: 同一催化剂体系在多篇文献中出现时, 取性能最优或实验条件最完整的记录. (4)非文本数据提取: 对于在文献中未直接列于表格或文本中的数据, 采用WebPlotDigitizer手动校准坐标轴后从图像数据中提取, 每点重复提取三次取平均值, 与表格数据交叉验证, 相对误差控制在2%以内.

4.2 模型开发与评估

本研究中, 采用分层抽样策略, 将数据集按照8∶2分为训练集和测试集. 为了减少过度拟合并提高泛化能力, 我们采用了十折交叉验证, 同时结合网格搜索优化模型超参数. 模型优化后, 利用完整训练集对模型进行再训练, 测试集用于机器学习模型的最终评估, 以确定表现最优模型并可用于预测. 评估的算法包括涵盖核方法和集成算法的9种回归算法: 线性回归(Linear Regression, LR)、岭回归(Ridge Regression, RR)、套索回归(Lasso Regression‌, LLR)、K近邻回归(K-Nearest Neighbor, KNN)、决策树回归(Decision Tree Regression, DTR)、随机森林回归(Random Forest Regression, RFR)、极端随机树回归(Extremely-randomized Trees Regression, ETR)、梯度提升回归(Gradient Boosting Decision Tree, GBDT)、极端梯度提升回归(eXtreme Gradient Boosting Regression, ‌XGBR). 采用决定系数(The coefficient of determination, R2)和均方根误差(Root Mean Squared Error, RMSE)作为评价模型预测准确度的标准, 选择具有最大R2和最小RMSE值的模型作为最佳模型. R2和RMSE的计算方法如下:
$\begin{array}{l} R^{2}=1-\frac{\sum_{i=1}^{N}\left(y_{i}-\hat{y}_{i}\right)^{2}}{\sum_{i=1}^{N}\left(y_{i}-\bar{y}\right)^{2}} \\ R M S E=\sqrt{\frac{1}{N} \sum_{i=1}^{N}\left(y_{i}-\hat{y}_{i}\right)^{2}} \end{array}$
其中, yi和$\hat{y}_{i}$分别代表每个样本目标值的真实值和预测值. $\bar{y}$代表所有样本目标真实值的平均值, N代表样本的数量.

4.3 可解释机器学习(IML)工具

使用SHAP (Shapley Additive Explanations)分析方法来解释机器学习模型预测结果. SHAP分析采用基于合作博弈论的公平分配方法, 确定每个特征对模型输出的重要性和贡献, 来揭示特征参数之间的相互作用关系, 提供对模型预测的全面解释.
(Cheng, B.)
[1]
Li H. Y.; Zheng Y. M.; Ji Y. L.; Yu M.; Shen Y. T.; Zhang S. R.; Liu Y. Y.; Wang H. Y.; Chen Z. W.; Dai X. D. Nat. Gas Oil 2025, 43, 129 (in Chinese).

(李洪言, 郑一鸣, 季银利, 于淼, 沈奕天, 张胜然, 刘永煜, 王海洋, 陈子文, 代晓东, 天然气与石油, 2025, 43, 129.)

[2]
Wang J.; Kong L. K.; Wu Y. R.; Gu M. L.; Chen X. Y. Chem. Ind. 2025, 43, 33 (in Chinese).

DOI

(王敬, 孔令凯, 吴亚冉, 顾明龙, 陈翔宇, 化学工业, 2025, 43, 33.)

[3]
Li W.; Ghosh A.; Bbosa D.; Brown R.; Wright M. M. ACS Sustain. Chem. Eng. 2018, 6, 16515.

DOI

[4]
Yang Z.; Liu S. M.; Xing L. Chem. Ind. 2025, 43, 1 (in Chinese).

(杨铮, 刘思明, 邢磊, 化学工业, 2025, 43, 1.)

[5]
He L.; Zhou B.; Sun D.; Li W.; Lv W.; Wang J.; Liang Y.; Lu A. ACS Catal. 2023, 13, 11291.

DOI

[6]
Xie S.; Li Z.; Luo S.; Zhang W. Renew. Sust. Energ. Rev. 2024, 192, 114240.

DOI

[7]
Eagan N. M.; Kumbhalkar M. D.; Buchanan J. S.; Dumesic J. A.; Huber G. W. Nat. Rev. Chem. 2019, 3, 223.

DOI

[8]
Sargent M. J.; Slater N. K. H.; Dennis J. S.; Smith G. J.; Pearlman P. S. Sep. Purif. Technol. 2022, 288, 120655.

DOI

[9]
Wei M.; Zhou Q.; Liu J. Energy Sci. Eng. 2025, 13, 2695.

DOI

[10]
Zhang C.; Si Z.; Chen B.; Chen C.; Chen H.; Ren W.; Cheng S.; Li S.; Cai D.; Qin P. J. Clean Prod. 2021, 285, 124902.

DOI

[11]
Pasel J.; Haeusler J.; Schmitt D.; Valencia H.; Mayer J.; Peters R. Appl.Catal. B-Environ. Energy. 2023, 324, 122286.

[12]
Zhang S.; Chen J.; Wei B.; Zhou H.; Hua K.; Liu X.; Wang H.; Sun Y. J. Am. Chem. Soc. 2024, 146, 6037.

DOI

[13]
Muck J.; Kocik J.; Hajek M.; Tisler Z.; Frolich K.; Kasparek, A. Appl. Catal. A-Gen. 2021, 626, 118380.

[14]
Xu X.; Zhang J.; Dong B.; Li F. Inorg. Chem. 2024, 63, 3843.

DOI

[15]
Chakraborty S.; Piszel P. E.; Hayes C. E.; Baker R. T.; Jones W. D. J. Am. Chem. Soc. 2015, 137, 14264.

DOI PMID

[16]
Koda K.; Matsu-Ura T.; Obora Y.; Ishii Y. Chem. Lett. 2009, 38, 838.

DOI

[17]
Dowson G. R. M.; Haddow M. F.; Lee J.; Wingad R. L.; Wass D. F. Angew. Chem.-Int. Ed. 2013, 52, 9005.

DOI

[18]
Wingad R. L.; Gates P. J.; Street S. T. G.; Wass D. F. ACS Catal. 2015, 5, 5822.

DOI

[19]
Fu S.; Shao Z.; Wang Y.; Liu Q. J. Am. Chem. Soc. 2017, 139, 11941.

DOI

[20]
Neumann C. N.; Rozeveld S. J.; Yu M.; Rieth A. J.; Dinca M. J. Am. Chem. Soc. 2019, 141, 17477.

DOI

[21]
Kulkarni N. V.; Brennessel W. W.; Jones W. D. ACS Catal. 2018, 8, 997.

DOI

[22]
Di Cosimo J. I.; Apestegu, A C. R.; Ginés M. J. L.; Iglesia E. J. Catal. 2000, 190, 261.

DOI

[23]
Carvalho D. L.; de Avillez R. R.; Rodrigues M. T.; Borges L. E. P.; Appel L. G. Appl. Catal. A-Gen. 2012, 415, 96.

[24]
Wang Q.; Zhou B.; Weng X.; Lv S.; Schueth F.; Lu A. Chem. Commun. 2019, 55, 10420.

DOI

[25]
Tsuchida T.; Kubo J.; Yoshioka T.; Sakuma S.; Takeguchi T.; Ueda W. J. Catal. 2008, 259, 183.

DOI

[26]
Yuan B.; Zhang J.; An Z.; Zhu Y.; Shu X.; Song H.; Xiang X.; Wang W.; Jing Y.; Zheng L.; He J. Appl. Catal. B-Environ. Energy. 2022, 309, 121271.

[27]
Riittonen T.; Toukoniitty E.; Madnani D. K.; Leino A.; Kordas K.; Szabo M.; Sapi A.; Arve K.; Warna J.; Mikkola J. Catalysts 2012, 2, 68.

DOI

[28]
Zhang J.; Shi K.; An Z.; Zhu Y.; Shu X.; Song H.; Xiang X.; He J. Ind. Eng. Chem. Res. 2020, 59, 3342.

DOI

[29]
Pang J.; Zheng M.; He L.; Li L.; Pan X.; Wang A.; Wang X.; Zhang T. J. Catal. 2016, 344, 184.

DOI

[30]
Wu X.; Cai X.; Zhang Q.; Bi P.; Meng Q.; Pi Y.; Wang T. ACS Sustain. Chem. Eng. 2021, 9, 11269.

DOI

[31]
Lv W.; He L.; Li W.; Zhou B.; Lv S.; Lu A. Green Chem. 2023, 25, 2653.

DOI

[32]
Wang Z.; Yin M.; Pang J.; Li X.; Xing Y.; Su Y.; Liu S.; Liu X.; Wu P.; Zheng M.; Zhang T. J. Energy Chem. 2022, 72, 306.

DOI

[33]
Quesada J.; Faba L.; Diaz E.; Ordonez S. ChemCatChem 2018, 10, 3583.

DOI

[34]
Lin X.; Fei X.; Chen D.; Qi Y.; Xu Q.; Liu Y.; Zhang Q.; Li S.; Wang T.; Qin Y.; Qiu X. ACS Catal. 2022, 12, 11573.

DOI

[35]
Jordison T. L.; Lira C. T.; Miller D. J. Ind. Eng. Chem. Res. 2015, 54, 10991.

DOI

[36]
Riittonen T.; Eranen K.; Maki-Arvela P.; Shchukarev A.; Rautio A.; Kordas K.; Kumar N.; Salmi T.; Mikkola J. Renew. Energy. 2015, 74, 369.

DOI

[37]
He J.; Li X.; Kou J.; Tao T.; Shen X.; Jiang D.; Lin L.; Li X. Catal. Sci. Technol. 2023, 13, 170.

DOI

[38]
Earley J. H.; Bourne R. A.; Watson M. J.; Poliakoff M. Green Chem. 2015, 17, 3018.

DOI

[39]
Wang Z.; Pang J.; Song L.; Li X.; Yuan Q.; Li X.; Liu S.; Zheng M. Ind. Eng. Chem. Res. 2020, 59, 22057.

DOI

[40]
Liu H.; Zheng T.; Hui T.; Zhang R.; Meng X.; Zhu W.; Liu H.; Liu Z. Chem. Eng. J. 2024, 481.

[41]
Lu B.; Ma S.; Liang S.; Wang Z.; Liu Y.; Mao S.; Ban H.; Wang L.; Wang Y. ACS Catal. 2023, 13, 4866.

DOI

[42]
Vermoortele F.; Ameloot R.; Vimont A.; Serre C.; De Vos D. Chem. Commun. 2011, 47, 1521.

DOI

[43]
Jiang D.; Fang G.; Tong Y.; Wu X.; Wang Y.; Hong D.; Leng W.; Liang Z.; Tu P.; Liu L.; Xu K.; Ni J.; Li X. ACS Catal. 2018, 8, 11973.

DOI

[44]
Zhou J.; He Y.; Xue B.; Cheng Y.; Zhou D.; Wang D.; He Y.; Guan W.; Fang K.; Zhang L.; Ni J.; Li X. Sustain. Energy Fuels. 2021, 5, 4628.

DOI

[45]
Wu X.; Fang G.; Liang Z.; Leng W.; Xu K.; Jiang D.; Ni J.; Li X. Catal. Commun. 2017, 100, 15.

DOI

[46]
Jiang D.; Wu X.; Mao J.; Ni J.; Li X. Chem. Commun. 2016, 52, 13749.

DOI

[47]
Hu J. Y.; Yang J. Y.; Hu S. L.; Liu J. X.; Li W. X. Sci. Sin. Chim. 2025, 55, 1704 (in Chinese).

DOI

(胡建钰, 杨峻毅, 胡素磊, 刘进勋, 李微雪, 中国科学(化学), 2025, 55, 1704.)

[48]
Li J. Q.; Song Q. X.; Liu Z. Y.; Wang D. Q. Acta Chim. Sinica 2024, 82, 387 (in Chinese).

DOI

(李珺卿, 宋千禧, 刘子义, 王东琪, 化学学报, 2024, 82, 387.)

DOI

[49]
Dong Y.; Ran M.; Zhang X.; Lin S.; Zhao H.; Yang Y.; Liu S.; Zheng C.; Gao X. ACS EST Eng. 2024, 4, 1312.

DOI

[50]
Toyao T.; Maeno Z.; Takakusagi S.; Kamachi T.; Takigawa I.; Shimizu K. ACS Catal. 2020, 10, 2260.

DOI

[51]
Takahashi K.; Ohyama J.; Nishimura S.; Fujima J.; Takahashi L.; Uno T.; Taniike T. Chem. Commun. 2023, 59, 2222.

DOI

[52]
Olu-Ajayi R.; Alaka H.; Sulaimon I.; Sunmola F.; Ajayi S. J. Build. Eng. 2022, 45, 103406.

[53]
Jayakumar T. P.; Babu S. P. S.; Nguyen T. N.; Le S. D.; Manchan R. P.; Phulkerd P.; Chammingkwan P.; Taniike T. Appl. Catal. A-Gen. 2023, 666, 119427.

DOI

[54]
Tripathi K.; Gupta V.; Awasthi V.; Pant K. K.; Upadhyayula S. Adv. Sustain. Syst. 2023, 7, 2200416.

DOI

[55]
Zhou Q.; Lu S.; Wu Y.; Wang J. J. Phys. Chem. Lett. 2020, 11, 3920.

DOI

[56]
Dong Y.; Zhang Y.; Ran M.; Zhang X.; Liu S.; Yang Y.; Hu W.; Zheng C.; Gao X. J. Mater. Chem. A 2021, 9, 23850.

DOI

[57]
Li S.; Zhang Y.; Hu Y.; Wang B.; Sun S.; Yang X.; He H. J. Materiomics 2021, 7, 1029.

[58]
Li W.; Dong Y.; Ran M.; Lin S.; Liu P.; Song H.; Yi J.; Zhu C.; Qi Z.; Zheng C.; Zhang X.; Gao X. J. Energy Chem. 2025, 104, 372.

DOI

[59]
Lundberg S. M.; Erion G.; Chen H.; Degrave A.; Prutkin J. M.; Nair B.; Katz R.; Himmelfarb J.; Bansal N.; Lee S. Nat. Mach. Intell. 2020, 2, 56.

DOI PMID

[60]
Ahmad M. W.; Reynolds J.; Rezgui Y. J. Clean Prod. 2018, 203, 810.

DOI

文章导航

/

〈 〉